В nginx не несколько алгоритмов балансировки, а один общий механизм
Представим внутренний сервис с двумя backend-серверами и соотношением нагрузки 10:1:
```nginx
upstream backend {
server a.internal weight=10 max_fails=2;
server b.internal weight=1;
}
```
Запросов немного - всего несколько десятков в минуту. Ночью сервер `a.internal` на несколько секунд потерял связь с сетью, а две попытки подключения завершились ошибкой. Утром узел уже давно восстановился, а время `fail_timeout` истекло.
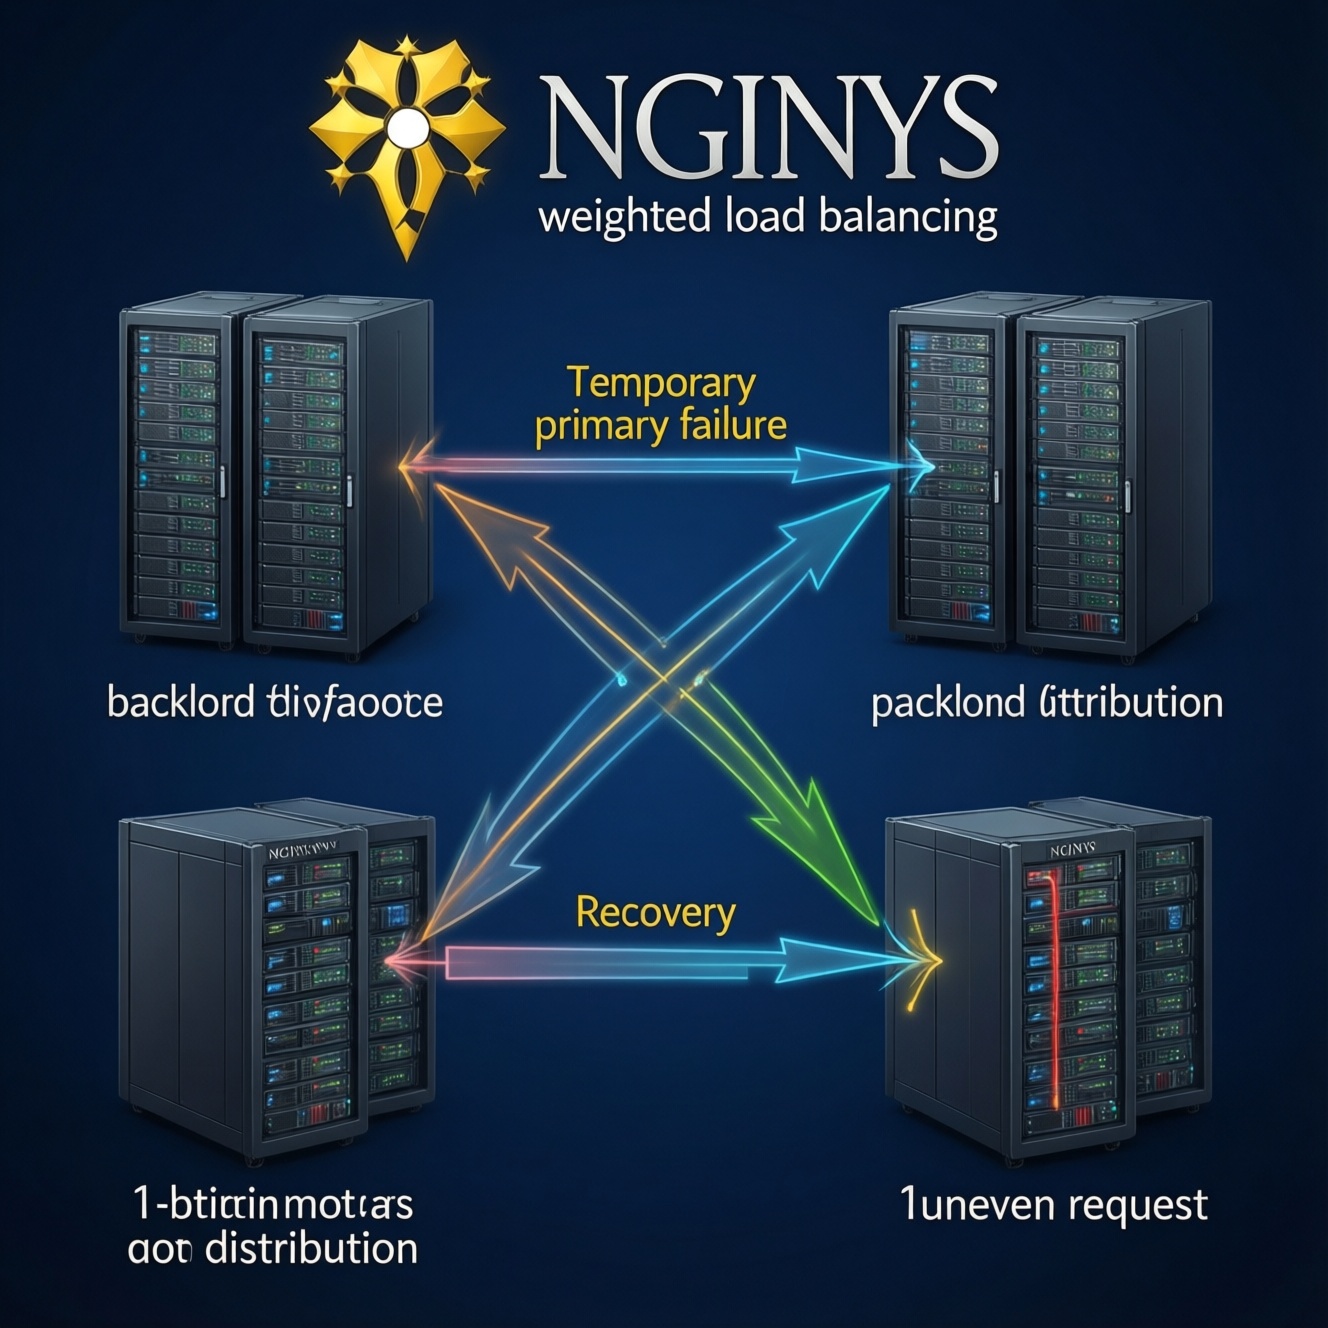
Логично ожидать, что после восстановления трафик снова будет распределяться примерно как 10 к 1. Но первые десятки запросов могут уходить иначе: иногда два обращения подряд отправляются на сервер `b`, несмотря на его вес `1` и полную доступность более мощного соседа.
В `access.log` с переменной `$upstream_addr` будет видно, куда направлялись запросы. Однако сам журнал не объяснит причину такого распределения. `error.log` при этом также может остаться пустым, а документация по `upstream` не раскрывает внутреннюю механику.
Разобраться помогает анализ исходного кода nginx версии `release-1.31.3`. Важная оговорка: ниже предполагается, что оба ночных сбоя пришлись на один worker-процесс. При использовании `zone` картина может быть другой, поскольку состояние upstream становится общим для нескольких workers.
В nginx фактически используется один базовый механизм
Документация перечисляет `round_robin`, `least_conn`, `least_time`, `ip_hash`, `hash` и `random` как разные способы балансировки. На практике это не полностью независимые алгоритмы. Большинство модулей лишь определяют порядок отбора кандидатов, а затем используют одну и ту же арифметику взвешенного выбора.
Внутри структуры соединения с upstream находятся два указателя на функции: одна выбирает peer, другая вызывается после завершения соединения. Директивы вроде `least_conn` или `ip_hash` фактически подменяют функцию выбора, а не включают отдельный универсальный балансировщик.
Основой служит smooth weighted round-robin. У каждого сервера есть три параметра:
- `weight` - значение из конфигурации;
- `current_weight` - изменяемый счётчик между запросами;
- `effective_weight` - внутренний показатель, которого нет в обычной документации.
На каждом шаге `current_weight` каждого доступного peer увеличивается на его вес. Побеждает сервер с максимальным значением. Затем из его счётчика вычитается сумма весов всех участников. Поэтому значение победителя может стать отрицательным: это не ошибка, а своеобразный "долг", который заставляет сервер некоторое время пропустить следующие запросы.
Такой подход отличается от старого weighted round-robin. При весах `{5, 1, 1}` прежняя схема могла отправить пять запросов подряд на один узел. Smooth-вариант сохраняет соотношение 5:1:1 на длинной дистанции, но распределяет обращения заметно равномернее.
Подробный разбор внутренней логики, включая роль `current_weight` и `effective_weight`, представлен в материале о [внутреннем механизме балансировки nginx](https://habr.com/ru/articles/1066752/?utm_campaign=1066752&utm_source=habrahabr&utm_medium=rss).
Почему после сбоя появляется "неправильный" трафик
После неудачного соединения nginx уменьшает `effective_weight` проблемного сервера. Это позволяет временно снизить вероятность повторного выбора неисправного peer. Когда сервер снова становится доступным, его эффективный вес постепенно восстанавливается.
Именно здесь возникает эффект, который трудно заметить при большом потоке запросов. Вес возвращается не мгновенно в смысле распределения всей очереди: внутренний счётчик восстанавливается поэтапно, а накопленный `current_weight` продолжает влиять на ближайшие решения. Поэтому сервер с исходным весом `10` может временно уступить несколько выборов узлу с весом `1`.
Низкая нагрузка делает явление особенно заметным. При тысячах запросов короткий переходный период растворяется в статистике. При десятках запросов в минуту каждое отдельное решение видно в логах почти без маскировки.
Настройка `max_fails` определяет, сколько неудачных попыток допускается за интервал `fail_timeout`, но не превращает upstream в полноценный health-checker. Параметры влияют на доступность peer и его эффективный вес, однако не отменяют общую механику плавного взвешенного выбора. Поэтому настройка nginx upstream max_fails должна рассматриваться вместе с тайм-аутами, характером ошибок и реальным временем восстановления сервера.
Как ведут себя другие режимы
`least_conn` выбирает peer с наименьшим числом активных соединений, но при равных или близких значениях снова использует весовую арифметику. Фактически сравнивается не только абсолютное количество соединений, а соотношение нагрузки и веса. Сервер с весом `10` может получить больше активных соединений и всё равно считаться менее загруженным относительно своей производительности.
`least_time`, появившийся в новых версиях nginx, добавляет к этой логике время ответа и количество активных соединений. Однако при отсутствии однозначного лидера он также опирается на тот же общий механизм выбора.
Для `hash` и `ip_hash` сначала определяется соответствие клиента или ключа конкретному диапазону. После этого веса влияют на размер диапазонов. В результате разные клиенты распределяются стабильно, но granularность зависит от количества ключей и соотношения весов. Небольшой поток клиентов может дать заметное отклонение от идеальной пропорции.
`consistent hash` решает другую задачу - уменьшает количество перемещённых ключей при добавлении или удалении серверов. Он не устраняет временные эффекты, связанные с состоянием peer, и не является универсальной заменой weighted round-robin.
Особняком стоит `random`: он действительно выбирает сервер случайно, а в варианте с двумя выборами может сравнивать кандидатов по нагрузке. Но и здесь веса задают вероятность попадания в выборку, поэтому статистические отклонения на короткой серии запросов остаются нормальными.
Отдельное исключение - `sticky`, появившийся в open source nginx начиная с версии 1.29.6. Он закрепляет клиента за определённым сервером, но при первоначальном выборе всё равно должен воспользоваться общей логикой. Иными словами, sticky не отменяет "долг" round-robin, а лишь использует его один раз, после чего сохраняет результат.
Что проверять на практике
Для диагностики полезно одновременно собирать `$upstream_addr`, `$upstream_status`, время подключения и время ответа. Одного адреса backend недостаточно: он показывает итог, но не объясняет, был ли peer выбран штатно, восстановлен после ошибки или исключён на короткий период.
Минимальный пример журнала может выглядеть так:
```nginx
log_format upstream_debug
'$remote_addr $request '
'upstream=$upstream_addr status=$upstream_status '
'connect=$upstream_connect_time '
'header=$upstream_header_time '
'response=$upstream_response_time';
access_log /var/log/nginx/upstream.log upstream_debug;
```
Затем стоит провести серию запросов с заранее известными весами, отдельно имитируя отказ одного сервера. Для малых объёмов трафика лучше анализировать не только итоговое соотношение, но и порядок первых 20-100 обращений.
Проверка должна учитывать количество worker-процессов. Без `zone` каждый worker хранит собственные счётчики выбора и состояние peer. Поэтому два клиента, попавшие в разные workers, могут наблюдать различную последовательность распределения. Включение общей зоны upstream синхронизирует состояние, но не превращает nginx в систему с идеальным глобальным балансировщиком.
```nginx
upstream backend {
zone backend_zone 64k;
server a.internal weight=10 max_fails=2 fail_timeout=10s;
server b.internal weight=1;
}
```
`zone` особенно важна в конфигурациях с несколькими workers и большим числом upstream-серверов. При этом необходимо учитывать версию nginx: новые режимы, включая `least_time` и `sticky`, могут отсутствовать в пакетах старых дистрибутивов. `least_time` появился в ветке 1.31.0, а open source-реализация `sticky` - в 1.29.6.
Главный вывод прост: алгоритмы балансировки нагрузки в nginx нельзя оценивать только по названию директивы. Настройка upstream nginx weight задаёт долгосрочную пропорцию, но не гарантирует точное соотношение на короткой серии. nginx балансировка нагрузки между серверами учитывает внутренние счётчики, ошибки, восстановление эффективного веса, состояние соединений и особенности worker-процессов.
Поэтому nginx weighted load balancing следует проверять на реальном трафике или в воспроизводимом симуляторе. Небольшие отклонения, последовательные обращения к серверу с меньшим весом и временная асимметрия после сбоя не обязательно свидетельствуют о неисправности. Чаще это прямое следствие smooth weighted round-robin и состояния, которое nginx хранит между запросами.